


Текст нужно уложить в лимит. Или понять, сколько слов в статье и сколько времени займёт её чтение. Или проверить, поместится ли описание в поле базы данных, где лимит в байтах, а не в символах. Подсчёт символов и слов показывает количество символов с пробелами и без, слов, предложений, абзацев и строк, размер текста в байтах UTF-8 и примерное время чтения. Подсчёт идёт при вводе.
В этой статье разберём, чем символы отличаются от байт, почему эмодзи считается одним символом, но занимает несколько байт и как считается время чтения.
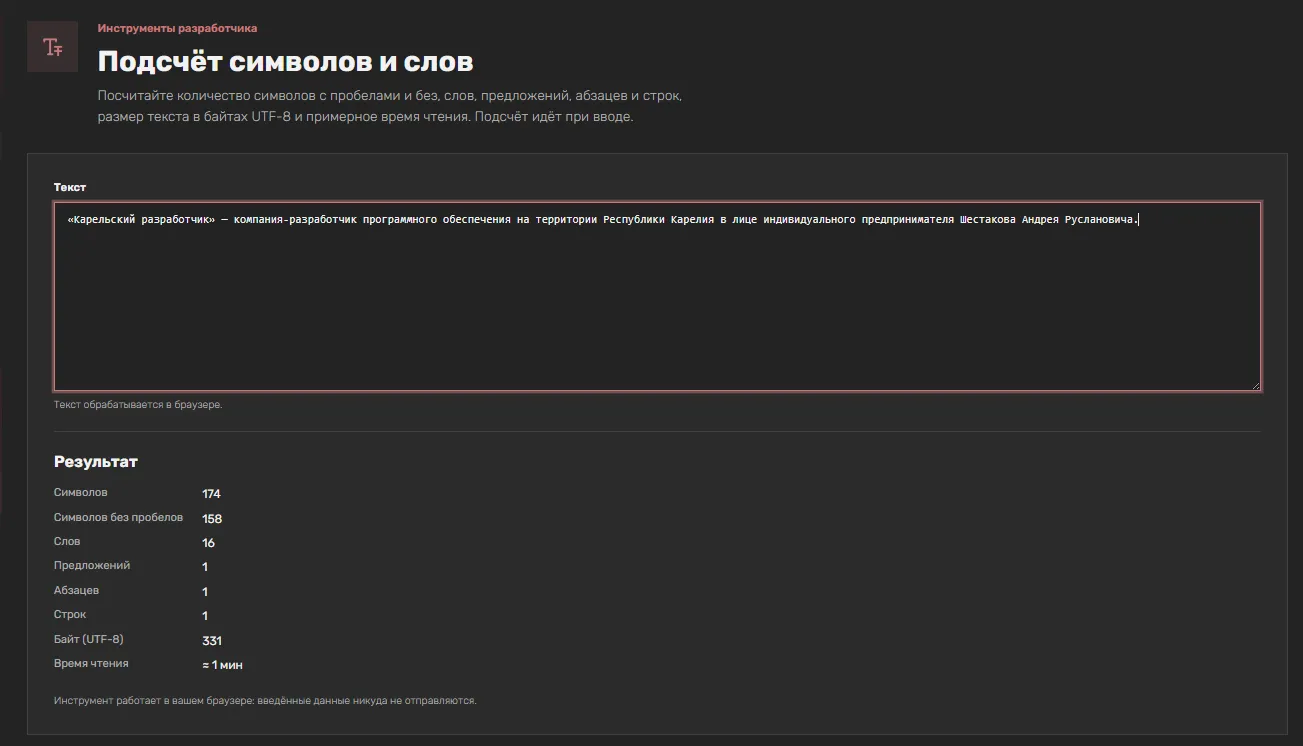
Что показывает инструмент
Подсчёт символов и слов обновляет показатели при вводе. Результат включает:
| Показатель | Что означает |
|---|---|
| Символов | Все символы, включая пробелы |
| Символов без пробелов | Все символы, кроме пробелов |
| Слов | Количество слов |
| Предложений | Количество предложений |
| Абзацев | Количество абзацев |
| Строк | Количество строк |
| Байт (UTF-8) | Размер текста в байтах |
| Время чтения | Примерное время чтения |
Текст обрабатывается в браузере: введённые данные никуда не отправляются.
Символы и байты: почему это разные вещи
Самое частое непонимание. Символ — это то, что видит читатель. Байт — единица хранения в компьютере. Один символ может занимать разное число байт в зависимости от кодировки.
В UTF-8:
| Символ | Байт |
|---|---|
Латинская буква (a) |
1 |
Кириллическая буква (а) |
2 |
Эмодзи (😀) |
4 |
| Китайский иероглиф | 3 |
Поэтому текст из 174 символов может занимать 331 байт: кириллица занимает по 2 байта, а пробелы и знаки препинания — по 1.
Это важно, потому что лимиты в базах данных и SMS часто считают байты, а не символы. Если поле ограничено 255 байтами, кириллический текст поместится примерно на 127 символов, а не на 255.
Эмодзи и составные символы
Инструмент считает эмодзи и составные символы одним символом, как их видит читатель. Это важно, потому что технически эмодзи может состоять из нескольких кодовых единиц.
| Пример | Как видит читатель | Сколько байт |
|---|---|---|
😀 |
1 символ | 4 |
👨👩👧 (семья) |
1 символ | 18 и больше |
e + комбинирующее ударение |
1 символ | 2–3 |
Если считать «по-программному», составной эмодзи может дать несколько символов. Инструмент считает так, как видит человек, — это ближе к тому, что ожидают редакторы и лимиты.
Слова, предложения, абзацы, строки
Каждый показатель считается по своим правилам.
| Показатель | Как считается |
|---|---|
| Слова | Последовательности символов, разделённые пробелами и знаками препинания |
| Предложения | Завершаются точкой, восклицательным или вопросительным знаком |
| Абзацы | Разделяются переводами строки |
| Строки | Количество строк в тексте |
Эти показатели полезны для редакторов, копирайтеров и SEO-специалистов: по ним оценивают объём статьи, сложность текста и структуру.
Время чтения
Инструмент считает время чтения из расчёта 200 слов в минуту — средняя скорость чтения про себя.
| Слов | Примерное время |
|---|---|
| 200 | 1 минута |
| 400 | 2 минуты |
| 1000 | 5 минут |
| 2000 | 10 минут |
Это ориентир, а не точное значение: скорость зависит от сложности текста, знакомства с темой и внимательности читателя. Для научных и технических текстов реальное время может быть больше.
Зачем считать символы и слова
| Задача | Что даёт инструмент |
|---|---|
| Лимит поля в базе | Байты UTF-8 показывают, поместится ли текст |
| SEO-статья | Количество слов и символов для оценки объёма |
| Соцсети и SMS | Символы с пробелами и байты для лимитов |
| Мета-описание | Символы без пробелов и с пробелами |
| Время чтения | Оценка для читателя |
| Редактура | Структура: предложения, абзацы, строки |
Ограничения инструмента
- Время чтения приблизительное. 200 слов в минуту — средняя скорость, не учитывает сложность.
- Правила подсчёта слов упрощены. Сложные случаи (дефисы, сокращения) могут считаться иначе, чем в других редакторах.
- Только текст. Инструмент не анализирует разметку и не отделяет её от текста.
- Байты зависят от кодировки. Показатель — для UTF-8. В других кодировках размер будет другим.
Как пользоваться: пошагово
- Вставьте или наберите текст.
- Показатели обновляются сразу.
- Смотрите нужный показатель: символы, слова, байты или время чтения.
Типичные ошибки
- Сравнивать символы и байты напрямую. Для кириллицы байт примерно в 2 раза больше символов. Для лимита в базе смотрите байты, а не символы.
- Ожидать, что эмодзи даст один байт. Эмодзи занимает 4 байта и больше, а составные — ещё больше.
- Считать время чтения точным. Это ориентир по средней скорости. Сложный текст читается дольше.
- Использовать символы для лимита SMS. SMS считает не символы, а части сообщения; для кириллицы лимит меньше.
- Забывать про пробелы. Для одних лимитов важны символы с пробелами, для других — без. Смотрите оба показателя.
- Путать строки и абзацы. Абзац разделяется переводом строки, строка — это любая строка текста, включая пустые.
Вопросы и ответы
Почему символов меньше, чем байт?
В UTF-8 латиница занимает 1 байт, кириллица — 2, эмодзи — 4. Лимиты в базах данных и SMS часто считают байты.
Как считается время чтения?
Из расчёта 200 слов в минуту — средняя скорость чтения про себя.
Почему эмодзи считается одним символом?
Инструмент считает так, как видит читатель. Технически эмодзи может состоять из нескольких кодовых единиц, но для человека это один символ.
Чем символы с пробелами отличаются от символов без пробелов?
С пробелами учитываются все символы, включая пробелы. Без пробелов — только значимые символы. Для разных лимитов важны разные показатели.
Можно ли использовать инструмент для лимита в базе данных?
Да, смотрите показатель «Байт (UTF-8)». Лимиты в базах данных часто задаются в байтах, а не в символах.
Почему время чтения для русского и английского одинаковое?
Скорость чтения примерно одинакова для обоих языков. Разница может быть в сложности текста, но не в языке как таком.
Итог
Подсчёт символов и слов — инструмент для подсчёта символов с пробелами и без, слов, предложений, абзацев, строк, размера в байтах UTF-8 и примерного времени чтения. Показатели обновляются при вводе, текст обрабатывается в браузере, а эмодзи и составные символы считаются так, как их видит читатель. Помните, что символы и байты — разные вещи, и для лимитов в базах данных смотрите байты, — и подсчёт будет работать на реальные задачи, а не на путаницу.